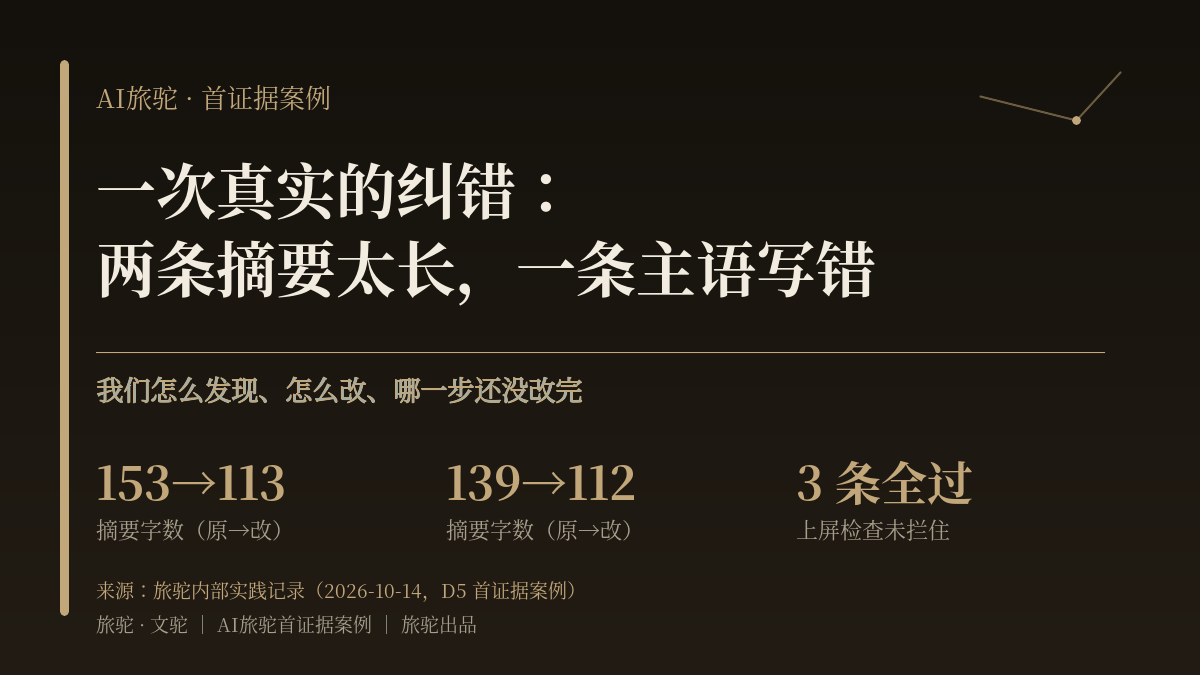
一次真实的纠错:两条摘要太长,一条主语写错——我们怎么发现、怎么改、哪一步还没改完
三篇稿子的上屏摘要都通过了检查,其中两条超出字数尺度、一条把“谁在筹钱”的主语写反。改的值已经对外生效;拦住同类错误的规则补丁换了文件,服务未重启,运行还没生效。
一、真实问题:三条摘要"检查全过",两条其实不合格
事情起于一次很普通的收尾:三篇稿子已经定稿、已经发布上线,接下来把摘要和封面补到列表页上。补之前,我们按惯例把三条待上屏的摘要拿出来核一遍,核出三个问题。
第一条,字数。栏目里在架的摘要有一个长期沿用的尺度:60 到 123 字、单段、不用省略号、不把标题再说一遍。当时在架的摘要最短 95 字、平均 116.1 字、最长 123 字——尺度不是拍脑袋定的,是从已有内容里量出来的。而这次准备上屏的三条里,两条分别写了 153 字和 139 字,明显在外面。
第二条,主语。据当时公开报道,139 字那条的第一句写的是某家芯片公司"自己筹集了 600 亿美元";回到正文一看,原意是"为这家公司安排融资的银行团筹集了 600 亿美元"。一个是"公司筹钱",一个是"别人替它筹钱"——主语错位,钱的来路就讲反了。本案例只核主语,金额本身没有在本轮独立回源;这是它的边界。
第三条最值得记:这三条摘要在上屏检查里全部通过了。 截至 2026 年 10 月 14 日傍晚,当时的检查只做一件事——看两个位置的摘要是否都填了、是否一模一样,再加上封面是否就绪。它判的是"两处一致",不是"这条摘要合不合格"。于是 153 字和 139 字,连同写错主语的那一条,都能被判定为"可以上屏"。
这就是那个真实问题的形状:一条口径,如果只写在人的记忆和文档里,没有变成检查动作,它就等于没有。
二、AI 协同过程:AI 把活干快,把对照做足
这一轮里,AI 不是"写手",更像一支同时干四件事的小队。
第一件是量尺子。要判断"153 字到底算不算长",不能靠感觉。我们把当时在架的全部摘要取出来,交给机器统计:最短、平均、最长各是多少,分布在哪里。读数出来是 95 / 116.1 / 123,尺度从"我们觉得"变成了"我们量过"。
第二件是做交叉核对。三条摘要逐句回正文:每一个数字、每一个主体、每一处因果,都要在正文里找到对应的句子。这一步机器做得很快——它把三条摘要拆成若干事实点,逐个去正文里比对,把"银行团"和"公司"这处主语差直接标了出来。没有这一步,主语错位很可能就跟着摘要一起上屏了。
第三件是把修改前后的差异列清楚。改摘要最容易出的事,是"顺手多改一句"。所以我们把改动限制在两处:只改摘要,不改标题、不改封面、不改正文、不改可见性;并把改前改后的字数、每一句的对应关系逐条列出来,供人逐条确认。
第四件是留证据。每条判断都要能回答"凭什么":字数靠统计脚本、字句靠正文比对、状态靠改动前后的读回记录。这一步枯燥,但它决定了后面出问题时,是"我们记得"还是"我们能证明"。
三、人工判断:三件事只有人能拍板
AI 把对照做足了,接下来三件事必须由人决定。
第一件:这算不算问题、要不要现在停。 三条稿子已经上线,摘要还在等上屏。此时有两个选择:照原样上屏,事后再修;或者先停下来把摘要改成合规值再上屏。停下来的成本是延迟约两小时,不停的成本是读者看到被截断的摘要——列表卡片只显示两行,超长摘要把判断句挤到看不见的位置。我们选择停。这个判断 AI 给不了,因为它涉及"哪个代价更不能接受"。
第二件:改成什么值。 AI 可以生成十条候选摘要,但"哪一条既保留判断、又不丢事实、还符合尺度"是编辑判断。最终的取值是:153 字那条改成 113 字,139 字那条改成 112 字,本来就合规的 122 字那条一个字不动——能不动就不动,减少改动面本身就是质量。
第三件:错在哪一层。 主语写错,很容易被当成"措辞不严谨"顺手抹平。但这里必须定性清楚:它不是语气问题,是事实主体问题——"谁在筹钱"讲错了,读者对这笔交易结构的理解就反了。定性不同,处置就不同:措辞问题可以润色,主体问题必须回到正文重核、并把这一类错误补进核对清单。
还有一处判断,事后看是这次最关键的:确认"检查没拦住"不是执行者的失误,而是检查本身缺一条。如果把它记成"某人疏忽",那么下一条 300 字的摘要还会照样过;只有记成"检查缺一条断言",修的方向才是对的。
四、执行结果(困难及修正):值改过来了,检查还没真正生效
先说改成的部分。
摘要按确认后的值落库,两个位置同值;改完之后做了 14 项逐条复验,执行方判据器记录全部通过,独立复核还没有进行。其中包括:在架内容数量不变、三篇详情页都可以正常打开、原有内容零回归、摘要字数回到尺度之内、对外可见的三条摘要与定稿值逐字一致。对外面也单独核了一遍:访问公开列表拿到的三条摘要字数正是 113 / 122 / 112——改的是我们,看到的也是新的。
再说没改完的部分,这部分要写得更准。
发现问题的当天,我们就准备了一份规则补丁:把"字数、单段、不用省略号"三条硬口径写进检查动作里,让机器在稿件上屏前就拦住超长摘要。补丁先做了沙盘验证,执行方记录 7 项全过:在架的 18 条摘要没有被误拦、153 字的样本被正确拒绝、换行和省略号的样本分别被拒绝、把补丁撤掉后样本恢复通过。
补丁文件在 10 月 14 日晚上被替换到现网目录;但服务进程在此前启动,之后没有重启,运行中的服务仍加载旧版本,所以新判据没有真正生效。我们当时写稿时只记了"文件还没替换",没记"文件已替换、服务未重启"——这两件事必须分开。部署或重启的回执,也没有留下。
所以这一段的现状必须写清楚:值已经修正并对外生效;规则补丁文件已替换,但服务未重启、运行未生效;部署/重启回执未见。 我们把它登记为未完成项,而不是"优化已完成"。
这一步的困难,比改一条摘要大得多,也正是这次实践最想记录的地方:一次真实的纠错,通常有两半——把错的改过来,和把"为什么会错"堵住。第二半往往不在自己的权限里,需要别的角色配合、需要停机窗口。写案例的时候,把第二半写成"已解决",是最容易犯的假;把"文件已替换"写成"运行已生效",同样是最容易犯的假。
五、可复用方法:三条能直接用的做法,一条边界
做法一:口径要配一把机器尺子。 任何"写在文档里的标准",都要同时有一个能自动跑的检查。字数是最好量的一类,先量它:把已有一批合格样本的分布算出来,得到自己的尺度(我们这次量出来是 95–123 字),再把它变成"不合格就拦住"的动作。标准只写在文档里,等于没有标准。
做法二:值要带着自检读数一起交付。 我们这次的问题之一,是修改后的值以纯文本形式给出,执行的一方只能逐字照抄——"逐字一致"保证的是一致性,不是合规性:如果给出去的本身就是超长值,逐字照抄只会把错值锁死。改成"值+字数+格式自检"一起交付之后,执行方在落库前就能发现不合格,成本几乎为零;而上屏之后再改,就要再开一次写窗口。
做法三:把"发现问题的时机"当成质量指标。 同一类错误,在稿件阶段发现、在上屏前发现、在上屏后发现,代价差一个量级。这次是在上屏前发现——代价是延迟约两小时;如果在上屏后发现,代价是一次对外修正+一次复验+读者已经看到的错。所以我们的做法是:把核对动作前置到"最后一次能低成本改动的时刻",而不是等发布后靠复核兜底。
一条边界:把"验证通过""文件替换""运行生效"分开写。 验证通过不等于上线;文件替换不等于服务已加载;上线不等于有回执。这次的规则补丁沙盘 7/7 通过,文件也在 10 月 14 日晚上替换了,但服务没有重启、运行没有生效,部署/重启回执也没有留下。对外表达时如果写成"规则已修正",是对读者不诚实;正确的写法是把几件事分别记录:值已改、文件已替换、服务未生效、回执缺口、责任在谁、卡在什么环节。这也是我们给这个案例定的边界——不虚构、不用模拟数据、不把未完成写成已完成。
---
这是"AI旅驼"的第一件案例。它记录的不是一次成功的发布,而是一次被抓住的错:一把没人带的尺子、一句写错主语的话、一条漏掉断言的检查,以及我们各自做了什么。案例的全部过程记录留在内部审阅层;其中第三方金额与部分内部记录为定位引用,没有随公开稿导出,可逐条回溯但不等于已独立验证。对外表达在获得发布与触达授权之前,不会出现在任何对外位置。